BTC
Bitcoin
6 365 362 ₽
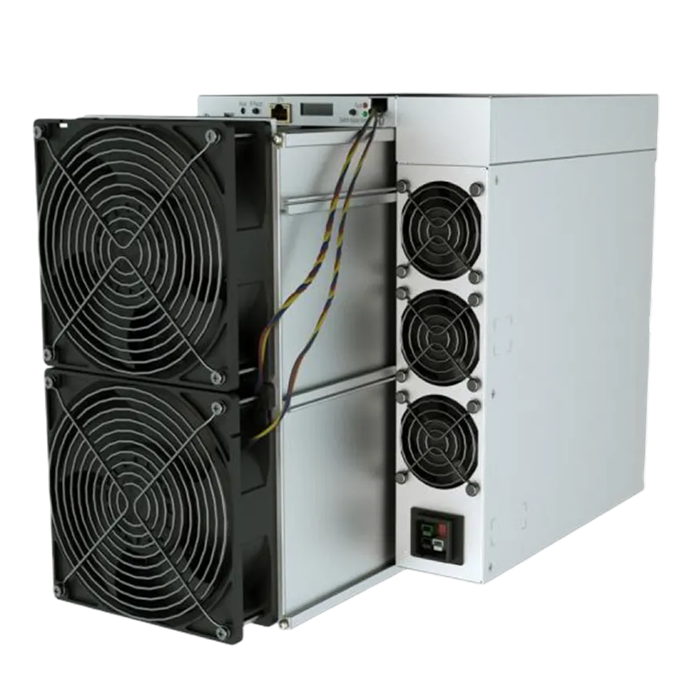
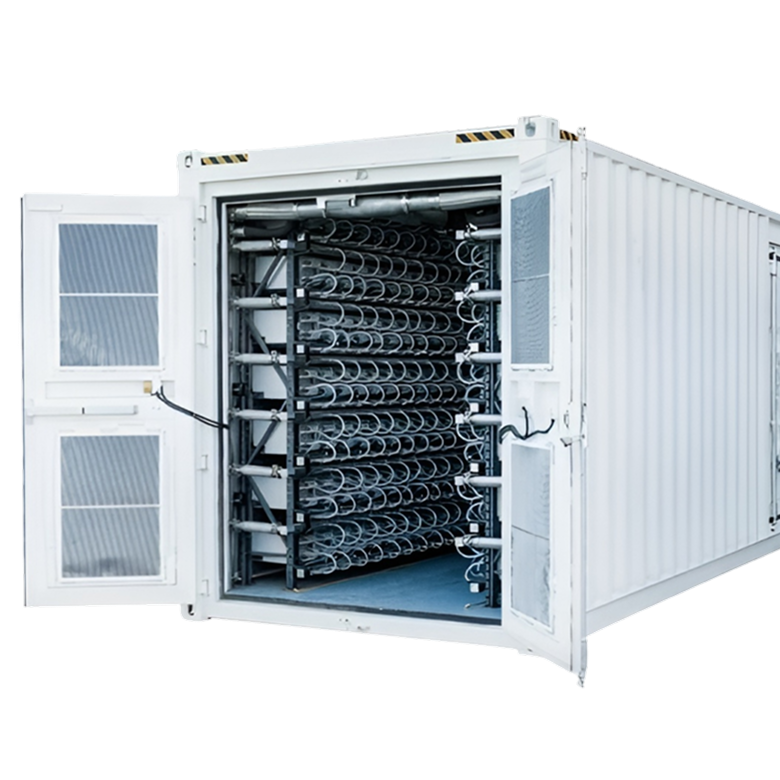
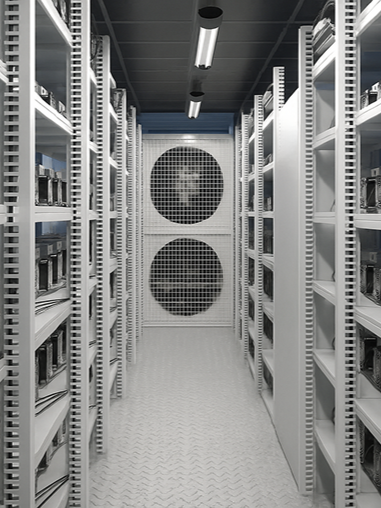


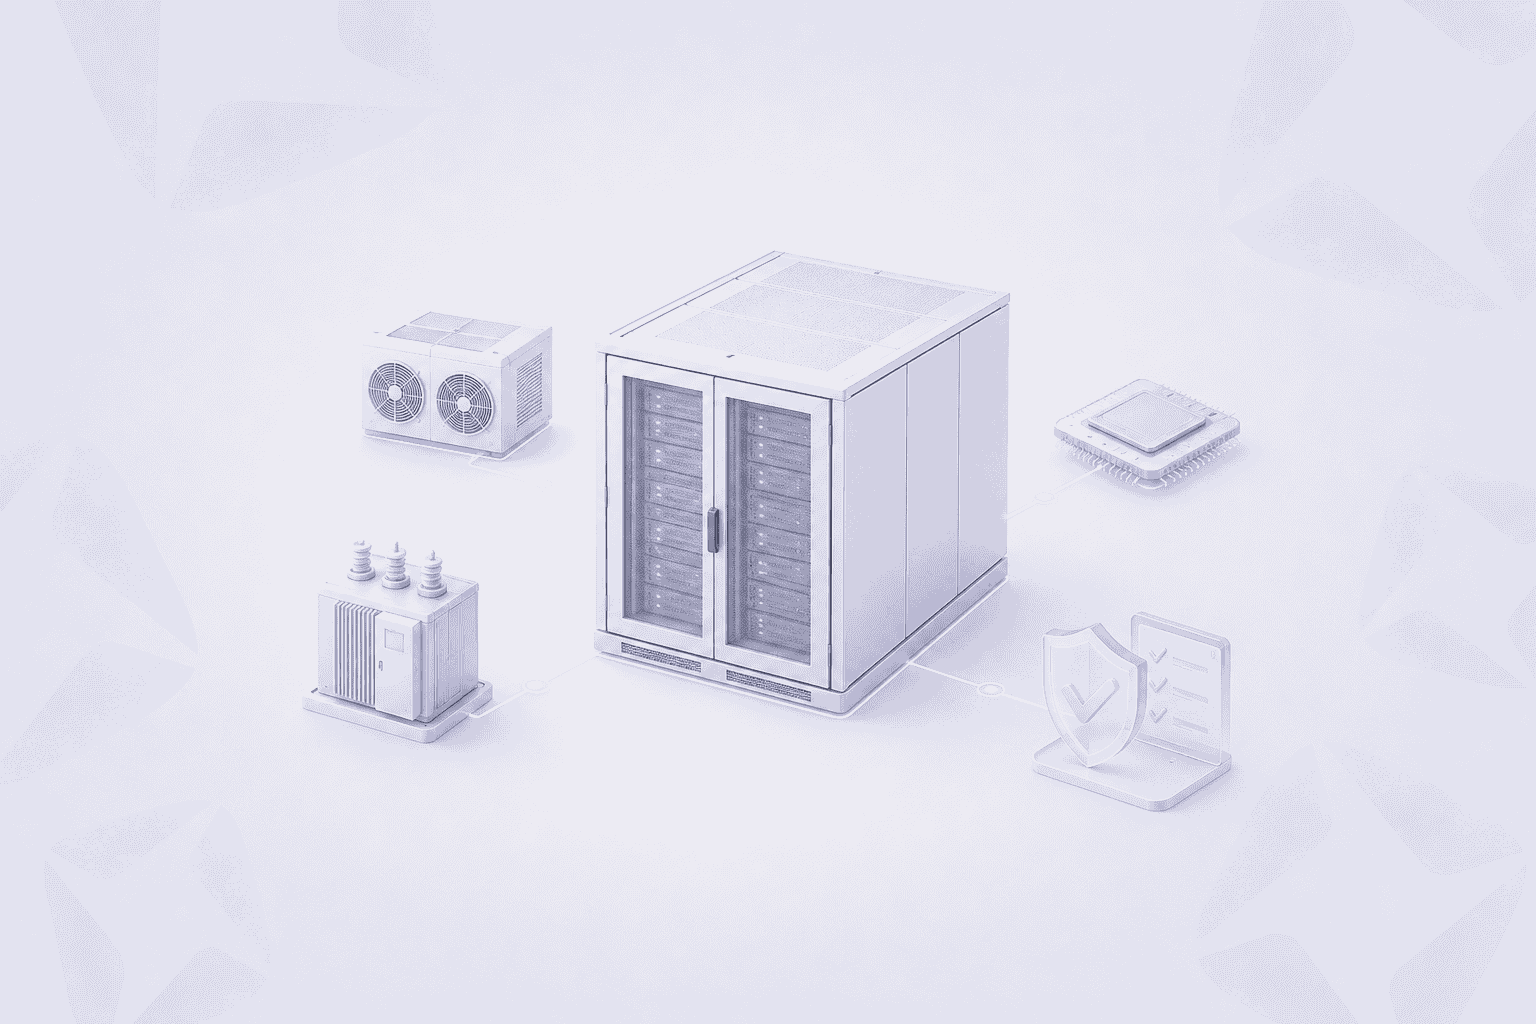
Дата-центр для AI-вычислений должен обеспечивать шесть ключевых условий: высокую доступную мощность на стойку, эффективный отвод тепла, резервированное электропитание, высокоскоростную сеть с низкой задержкой, производительное хранилище и постоянный мониторинг инженерной инфраструктуры. Для высокоплотных GPU-кластеров дополнительно требуется жидкостное охлаждение или как минимум техническая готовность к его внедрению.
Главное отличие AI-дата-центра от обычного ЦОД — высокая концентрация нагрузки. Современная стойка с GPU может потреблять десятки киловатт, а в наиболее плотных конфигурациях — порядка 100 кВт и более. Поэтому наличие свободного места в стойках еще не означает, что площадка подходит для AI: ограничением чаще становятся электропитание, охлаждение и возможности сети.
Для большинства новых AI-площадок оптимален дата-центр, который уже рассчитан на высокоплотные стойки и позволяет в дальнейшем перейти на direct-to-chip liquid cooling без полной реконструкции инженерной инфраструктуры. Воздушное охлаждение остается рабочим вариантом для менее плотных кластеров, если система вентиляции способна стабильно отводить полное тепловыделение оборудования.
| Требование | Что необходимо | Почему это важно |
|---|---|---|
| Электрическая мощность | Достаточная мощность на каждую стойку с запасом на расширение | GPU-серверы создают очень высокую локальную нагрузку |
| Охлаждение | Отвод полного тепловыделения оборудования | Недостаток охлаждения приводит к снижению производительности и аварийным отключениям |
| Резервирование | Независимые линии питания, UPS и резервная генерация | Сбой одного узла может остановить распределенную AI-задачу |
| Сеть | Высокая пропускная способность и низкая задержка | GPU должны быстро обмениваться данными между серверами |
| Хранилище | Высокая скорость параллельного чтения и записи | Медленное storage заставляет дорогостоящие GPU простаивать |
| Мониторинг | Контроль питания, температуры, охлаждения и состояния оборудования | Позволяет заранее обнаруживать перегрузки и отказы |
При выборе AI-дата-центра важно смотреть не только на общую доступную мощность объекта в мегаваттах, но прежде всего на максимальную мощность, которую площадка способна постоянно подать на одну стойку.
Один современный GPU-сервер может потреблять более 10 кВт. Если в стойке размещается несколько таких узлов вместе с сетевым оборудованием, суммарная нагрузка быстро достигает нескольких десятков киловатт. Rack-scale системы нового поколения способны поднимать этот показатель примерно до 100–120 кВт и выше.
Поэтому инженерная система должна выдерживать не только среднее, но и пиковое потребление. Для AI-нагрузок это особенно важно: при запуске интенсивной вычислительной задачи большое количество ускорителей может одновременно перейти к высокой загрузке.
Площадка должна обеспечивать:
достаточный лимит мощности непосредственно на стойку;
распределение нагрузки по нескольким линиям питания;
резервирование критических элементов;
UPS для защиты от кратковременных перебоев;
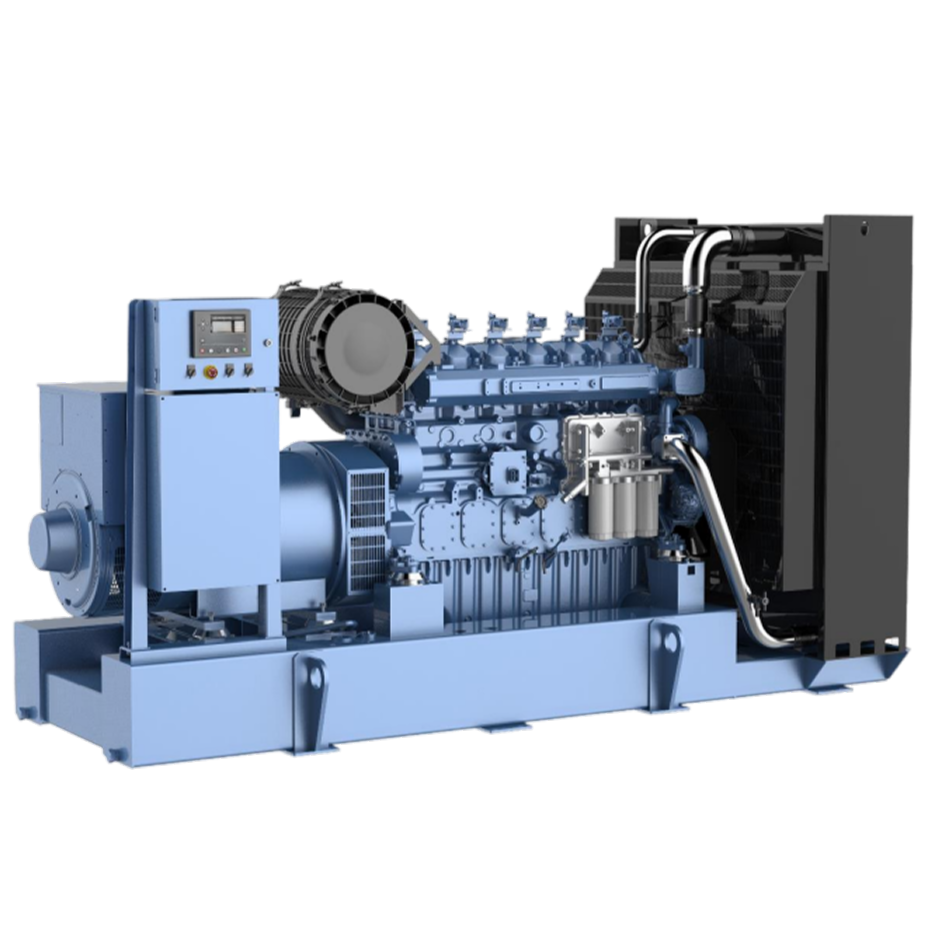
резервную генерацию;
мониторинг потребления хотя бы на уровне стойки и PDU;
возможность увеличения мощности при расширении кластера.
Практический критерий прост: если серверная стойка физически вмещает оборудование, но инженерная инфраструктура способна подать только часть необходимой мощности, свободные юниты не имеют практической ценности.
Строительство дата-центров Promminer — проектирование и строительство промышленных дата-центров под ключ с расчетом энергоснабжения, инженерной инфраструктурой, монтажом оборудования и вводом объекта в эксплуатацию.
Практически вся электрическая энергия, потребляемая GPU-серверами, превращается в тепло. Поэтому стойка с потреблением 50 кВт создает сопоставимую тепловую нагрузку, которую необходимо непрерывно отводить.
Для умеренной плотности остается применимым воздушное охлаждение. Оно требует достаточного воздушного потока, правильной организации холодных и горячих коридоров и предотвращения рециркуляции нагретого воздуха. Чем выше плотность оборудования, тем сложнее обеспечить нужный объем воздуха через ограниченное пространство стойки.
Именно поэтому для высокоплотных AI-кластеров все чаще используется жидкостное охлаждение. При direct-to-chip cooling тепло от GPU и других наиболее горячих компонентов передается непосредственно в жидкостный контур. Это позволяет эффективнее отводить десятки и сотни киловатт тепла с одной стойки.
Выбор можно свести к трем сценариям:
небольшой или умеренно плотный GPU-кластер — качественного воздушного охлаждения может быть достаточно;
высокоплотный кластер — предпочтительно жидкостное охлаждение;
новый дата-центр с расчетом на несколько поколений GPU — желательно сразу предусмотреть трубопроводы, теплообменники, CDU и другие элементы либо хотя бы место и подключения для их дальнейшей установки.
Не стоит выбирать площадку только по заявленной общей холодопроизводительности. Нужно выяснять, какую тепловую нагрузку система способна снять именно с одной AI-стойки.
Для обычной серверной инфраструктуры высокая скорость доступа в интернет часто важнее внутренней связи между серверами. В AI-кластере ситуация обратная: значительная часть нагрузки приходится на east-west-трафик внутри дата-центра.
При распределенном обучении одной модели десятки или сотни GPU регулярно синхронизируют параметры и передают большие объемы данных между вычислительными узлами. Если сеть не успевает за ускорителями, GPU начинают ждать обмена данными, а фактическая производительность кластера снижается.
Поэтому AI-дата-центр должен поддерживать сеть с:
высокой пропускной способностью;
низкой и предсказуемой задержкой;
достаточным количеством высокоскоростных портов;
архитектурой без значительной переподписки на критических участках;
резервированием ключевых коммутаторов и соединений;
физической инфраструктурой под необходимое количество оптических и медных линий.
В крупных GPU-кластерах используются InfiniBand и высокоскоростной Ethernet. Конкретная технология и скорость зависят от архитектуры оборудования и масштаба проекта, поэтому универсального требования вида «AI-дата-центру обязательно нужен порт определенной скорости» нет.
Правильный критерий другой: сеть должна позволять вычислительным узлам обмениваться данными достаточно быстро, чтобы коммуникации не становились ограничением производительности GPU.
Даже мощный кластер теряет смысл, если вычислительные узлы регулярно простаивают в ожидании данных. Поэтому storage для AI оценивают не только по объему в терабайтах или петабайтах, но и по скорости параллельного доступа.
Наибольшая нагрузка возникает при:
чтении больших тренировочных датасетов;
одновременной работе множества вычислительных узлов;
сохранении checkpoint;
повторном запуске задач;
подготовке и перемещении датасетов между слоями хранения.
На практике эффективна многоуровневая архитектура. Быстрое общее хранилище используется для активных наборов данных и checkpoint, локальные NVMe — для кэша и временных данных, а более емкое и дешевое storage — для архивов и редко используемых датасетов.
Это позволяет не использовать дорогое высокопроизводительное хранилище для всего массива информации одновременно.
При оценке площадки важно учитывать производительность не только дисковой системы, но и сети хранения. Быстрый storage мало поможет, если его соединение с GPU-кластером ограничено по пропускной способности.
AI-задача может одновременно выполняться на большом количестве GPU. Поэтому отказ одного сервера, сетевого элемента или линии электропитания иногда приводит не к потере части вычислительной мощности, а к остановке всего распределенного процесса.
Для крупных тренировочных кластеров это особенно чувствительно: вычисления могут выполняться много часов или дней, а восстановление после сбоя зависит от того, насколько недавно был сохранен checkpoint.
Поэтому дата-центр должен иметь резервирование критической инфраструктуры: питания, охлаждения, сетевых устройств и систем управления. Важна и возможность выполнять техническое обслуживание без полного отключения вычислительного сегмента.
При этом максимальная отказоустойчивость нужна не каждому AI-проекту. Для экспериментального inference или задач, которые легко перезапускаются, допустим более простой уровень резервирования. Для длительного обучения крупных моделей стоимость простоя гораздо выше, поэтому требования к надежности становятся жестче.
При выборе площадки сначала определяют конфигурацию GPU-кластера, а уже затем проверяют, соответствует ли ей дата-центр. Обратный подход — сначала арендовать стойки, а потом пытаться разместить оборудование — часто приводит к ограничениям по мощности или охлаждению.
Достаточно проверить пять основных параметров:
Мощность на стойку. Сколько киловатт доступно постоянно и можно ли увеличить лимит при масштабировании.
Охлаждение. Какую реальную тепловую нагрузку площадка отводит с одной стойки и поддерживает ли liquid cooling.
Резервирование. Есть ли независимые линии питания, UPS, генераторы и резервирование инженерных систем.
Сеть. Поддерживаются ли требуемые скорости, топология и количество соединений между GPU-серверами.
Storage и мониторинг. Обеспечивает ли хранилище необходимую производительность и контролируются ли температура, питание и состояние охлаждения.
Особенно осторожно стоит относиться к обычным colocation-площадкам, где мощность равномерно распределена между большим количеством малонагруженных стоек. Формально такой ЦОД может иметь большой запас мощности, но не быть способен выделить необходимые десятки киловатт в одной точке.
Для AI-вычислений недостаточно обычного серверного помещения со свободными стойками и доступом в интернет. Площадка должна одновременно обеспечивать высокую мощность на стойку, соответствующее ей охлаждение, резервированное питание, высокоскоростную внутреннюю сеть, производительное хранилище и инженерный мониторинг.
Для небольших и умеренно плотных GPU-кластеров может быть достаточно воздушного охлаждения. Если планируется высокая плотность оборудования или переход на следующие поколения ускорителей, предпочтителен дата-центр с жидкостным охлаждением либо с готовой инфраструктурой для его внедрения.
Главный критерий при выборе AI-дата-центра — сколько вычислительного оборудования площадка способна одновременно питать, охлаждать и объединять сетью без снижения производительности и надежности кластера.
Материал носит исключительно информационный характер и не является индивидуальной инвестиционной рекомендацией. Информация в материале не учитывает индивидуальные финансовые цели, инвестиционный профиль и допустимый уровень риска конкретного лица.